Hermes Agent는 Nous Research의 오픈소스 자율 에이전트다. 데스크톱 앱과 CLI/TUI로 구성되며, IDE 플러그인이 아니다. 영구 메모리, 스킬 시스템, 그리고 진짜 서브에이전트 위임 기능을 갖추고 있다. 이 시리즈의 다른 도구들과 마찬가지로 어떤 OpenAI 호환 커스텀 엔드포인트도 지원하므로, Token Station을 지정하면 OpenAI의 GPT-5.6 패밀리(Sol, Terra, Luna)를 선택 가능한 모델로 추가할 수 있고, 모두 자신의 Token Station 키로 과금된다.
이 글이 따로 다룰 가치가 있는 이유는 이렇다. Hermes의 위임 기능은 서브에이전트를 부모 대화와 다른 모델에서 실제로 실행할 수 있게 해준다. 이게 어디서나 성립하는 이야기는 아니다. Cursor 시리즈에서는 Cursor의 서브에이전트 model: 필드가 유효하고 문서화된 문법이지만 실제로는 아무 동작도 하지 않는다는 점을 기록해야 했다. 무엇을 지정하든 모든 서브에이전트는 조용히 부모 대화의 모델로 실행된다. Hermes의 delegation.model과 delegation.provider 설정은 위임한 작업을 실제로 다른 모델로 라우팅한다. 이는 아래에서 두 모델이 Token Station 자체 대시보드에 각각 따로 과금되어 나타나는 것으로 확인한다.
설정에 들어가기 전에, 프로바이더에 직접 돈을 내는 대신 Token Station을 거쳐 라우팅하는 다른 도구들과 같은 이유가 여기에도 적용된다. 비용 가시성(모든 요청이 프로바이더의 실제 요율로 마진 없이 과금되어 자신의 대시보드에 그대로 나타난다)과 통합 관리(같은 키와 같은 모델 ID가 사용 중인 모든 도구에서 작동한다. Hermes도 예외가 아니며, 도구마다 별도의 키와 청구서를 준비할 필요가 없다)다.
시작하기 전에 필요한 것
- Hermes Agent 설치. 데스크톱 앱은 hermes-agent.nousresearch.com에서, CLI만 설치하려면
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash(Linux/macOS/WSL2) 또는iex (irm https://hermes-agent.nousresearch.com/install.ps1)(Windows PowerShell). - Token Station 계정과 API 키. models.bytefuture.ai에서 무료로 가입할 수 있으며 카드는 필요 없다.
1단계: Token Station을 커스텀 엔드포인트로 등록하기
Hermes 데스크톱 앱에서 Settings → Providers → Custom Endpoints를 열고 + Add Endpoint를 클릭한다:
- Name:
Token Station - Provider ID:
token-station - Endpoint URL:
https://models.bytefuture.ai/v1 - Default Model:
openai/gpt-5.6-sol - Context:
1050000(Token Station에서 Sol의 실제 컨텍스트 윈도우다. 실제로 어떤 값으로 해석되는지 확인하지 않은 채 “Auto”로 두지 말 것) - API Key: 자신의 Token Station 키
- Use for new chats와 Discover models는 체크된 상태로 둔다
Save를 누르기 전에 Test를 클릭하자. Discover models가 켜져 있으면, 정상 작동하는 엔드포인트는 자신의 키가 볼 수 있는 모든 모델을 반환한다. 확인 메시지는 “Endpoint is reachable. Found 14 models.“였다. 저장하면 모델 선택기의 “TOKEN STATION” 섹션에 전체 카탈로그가 나타난다. Sol과 Luna도 포함되어 있으며 두 번째 엔드포인트는 필요 없다.
초록색 Test 결과만 보고 멈추지 말자. 새 세션을 열어 실제로 openai/gpt-5.6-sol을 선택하고 사소한 메시지를 보내보자. 실제 응답만이 키와 URL, 모델 이름이 엔드투엔드로 모두 올바르다는 유일한 증거다.
2단계: 실제 도구 사용 확인하기(채팅뿐 아니라)
채팅에서 응답하는 모델과 실제로 행동할 수 있는 모델은 다르다. CLI(터미널에서 hermes)로 전환해서 실제 파일 작성이 필요한 작업을 맡겨보자:
이는 Cursor+OpenAI 글에서 수정이 들어가기 전에 겪었던 것과 같은 함정이다. 코드를 읽고 논의하는 것과 실제로 편집하는 것은 다르다. 이번에는 수정이 필요 없었다. Sol은 unit_conversion.py를 작성하고 printf '10\n' | python C:\Users\ethan\unit_conversion.py를 실행한 다음, 코드가 무엇을 해야 하는지 설명하는 대신 실제 출력(“Test run with 10 inches produced 25.4 centimeters”)을 보고했다.
3단계: 위임을 더 저렴한 모델로 지정하기
Hermes에서 위임된 하위 작업은 delegation.model과 delegation.provider로 설정해서 부모 대화와 다른 모델에서 실행할 수 있다. Hermes는 자체 터미널 도구를 가지고 있으므로, 채팅 세션에서 Hermes에게 직접 이 명령을 실행해달라고 요청하는 방식으로 설정할 수 있다:
hermes config set delegation.model openai/gpt-5.6-luna
hermes config set delegation.provider token-station
Hermes는 둘 다 확인해주었다: “Set and verified: delegation.model = openai/gpt-5.6-luna”와 “Set and verified: delegation.provider = token-station”. 확인 메시지 텍스트만 믿기보다 다시 한번 확인해볼 가치가 있다:
hermes config get delegation.model
hermes config get delegation.provider| Model | Cost (input/output per M) | Role in this setup |
|---|---|---|
openai/gpt-5.6-sol |
$5 / $30 | 메인 에이전트: 작업을 계획하고, 범위가 명확한 하위 작업을 위임한다. |
openai/gpt-5.6-luna |
$1 / $6 | 위임받는 워커: 넘겨받은, 범위가 명확한 작업을 실행한다. |
openai/gpt-5.6-terra |
$2.50 / $15 | 같은 엔드포인트에서 사용할 수 있지만, 이 데모에서는 쓰지 않았다. |
4단계: 위임이 실제로 더 저렴한 모델에 도달하는지 확인하기
2단계에서 이미 unit_conversion.py가 만들어져 있으니, 범위가 명확한 하위 작업의 위임이 분명히 필요한 작업을 줘보자:
Add input validation to unit_conversion.py. Delegate to a subagent (via delegate_task) the job of writing three test cases covering negative numbers, zero, and non-numeric input, with context that the file lives at C:\Users\ethan\unit_conversion.py and takes inches, outputs centimeters. Once the subagent returns, incorporate its test cases into a new test_unit_conversion.py, then run it and report the results.Hermes는 범위가 명확하고 그 자체로 완결된 지시로 서브에이전트를 생성했다: “Write three unit-test cases for unit_conversion.py covering negative numbers, zero, and non-numeric input. Return the complete test code and briefly state the expected behavior for each case. Do not modify files.” Hermes의 서브에이전트는 부모 대화의 기록을 전혀 받지 않으므로 목표와 맥락이 그 자체로 완결되어 있어야 하는데, 여기서는 그랬다. 서브에이전트가 테스트를 작성했고, Sol은 그것을 test_unit_conversion.py에 통합하고 unit_conversion.py에 실제 입력 검증을 추가한 다음 테스트를 실행했다.
위임이 실제로 두 번째 모델을 사용했다는 증거는, 이 세션이 실행된 몇 분 동안의 Token Station Usage 페이지 요청 기록에 있다.
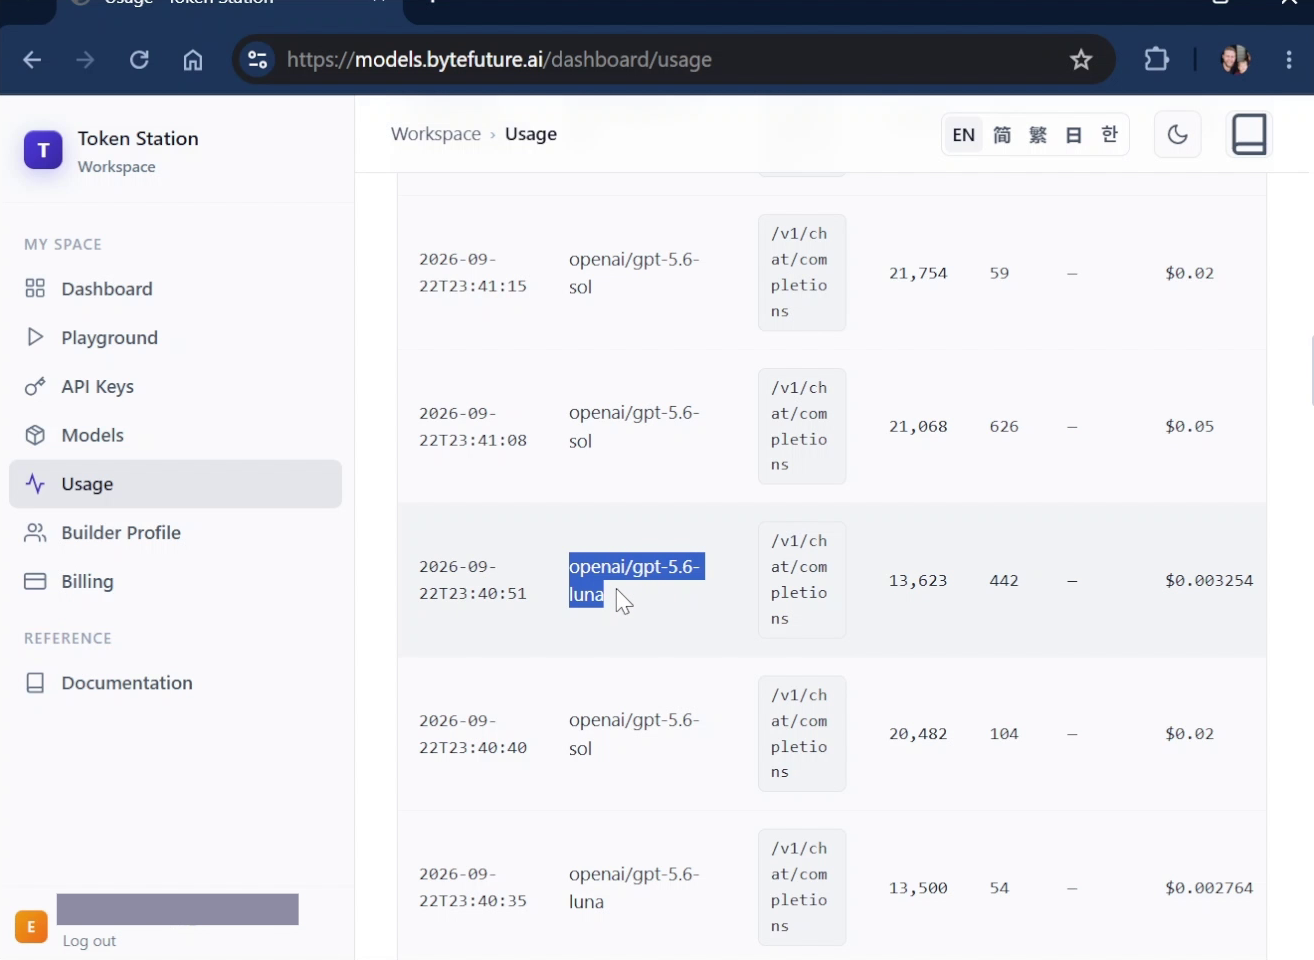
openai/gpt-5.6-sol과 openai/gpt-5.6-luna 요청은 같은 몇 분 사이 로그에서 번갈아 나타나며, 각각 고유한 토큰 수와 비용을 갖는다. 이는 프런티어 모델이 계획하고 저렴한 모델이 실행하는 패턴이 문서상의 주장이 아니라 실제로 작동한다는 증거다.
지금 되는 것
Hermes에서 Token Station을 커스텀 OpenAI 호환 엔드포인트로 등록하는 과정은 데스크톱 앱의 Settings에서 작동하며, 엔드포인트 하나로 전체 카탈로그가 자동으로 발견된다. 실제 도구 사용, 즉 실제 파일을 작성하고 실행하는 것은 단순한 채팅 응답을 넘어 openai/gpt-5.6-sol에서 확인되었다. 같은 Token Station 키로 더 저렴한 다른 모델에 위임하는 것도 엔드투엔드로 작동함이 확인되었다. delegation.model과 delegation.provider는 delegate_task 호출을 실제로 openai/gpt-5.6-luna로 라우팅하며, 부모 대화는 openai/gpt-5.6-sol에 그대로 남는다. 같은 세션 안에서 둘 다 Token Station 대시보드에 따로 과금되어 나타난다.
openai/gpt-5.6-terra도 같은 엔드포인트, 같은 설정으로 사용할 수 있지만, 이 글에서 따로 테스트하지는 않았다.
시작하기
models.bytefuture.ai에서 가입하자. 카드는 필요 없고, 첫 충전 시 최대 50달러까지 100% 매칭 보너스를 받을 수 있다. 키를 export하고 Hermes에 커스텀 엔드포인트로 등록한 다음, 위의 라우트를 추가하자.